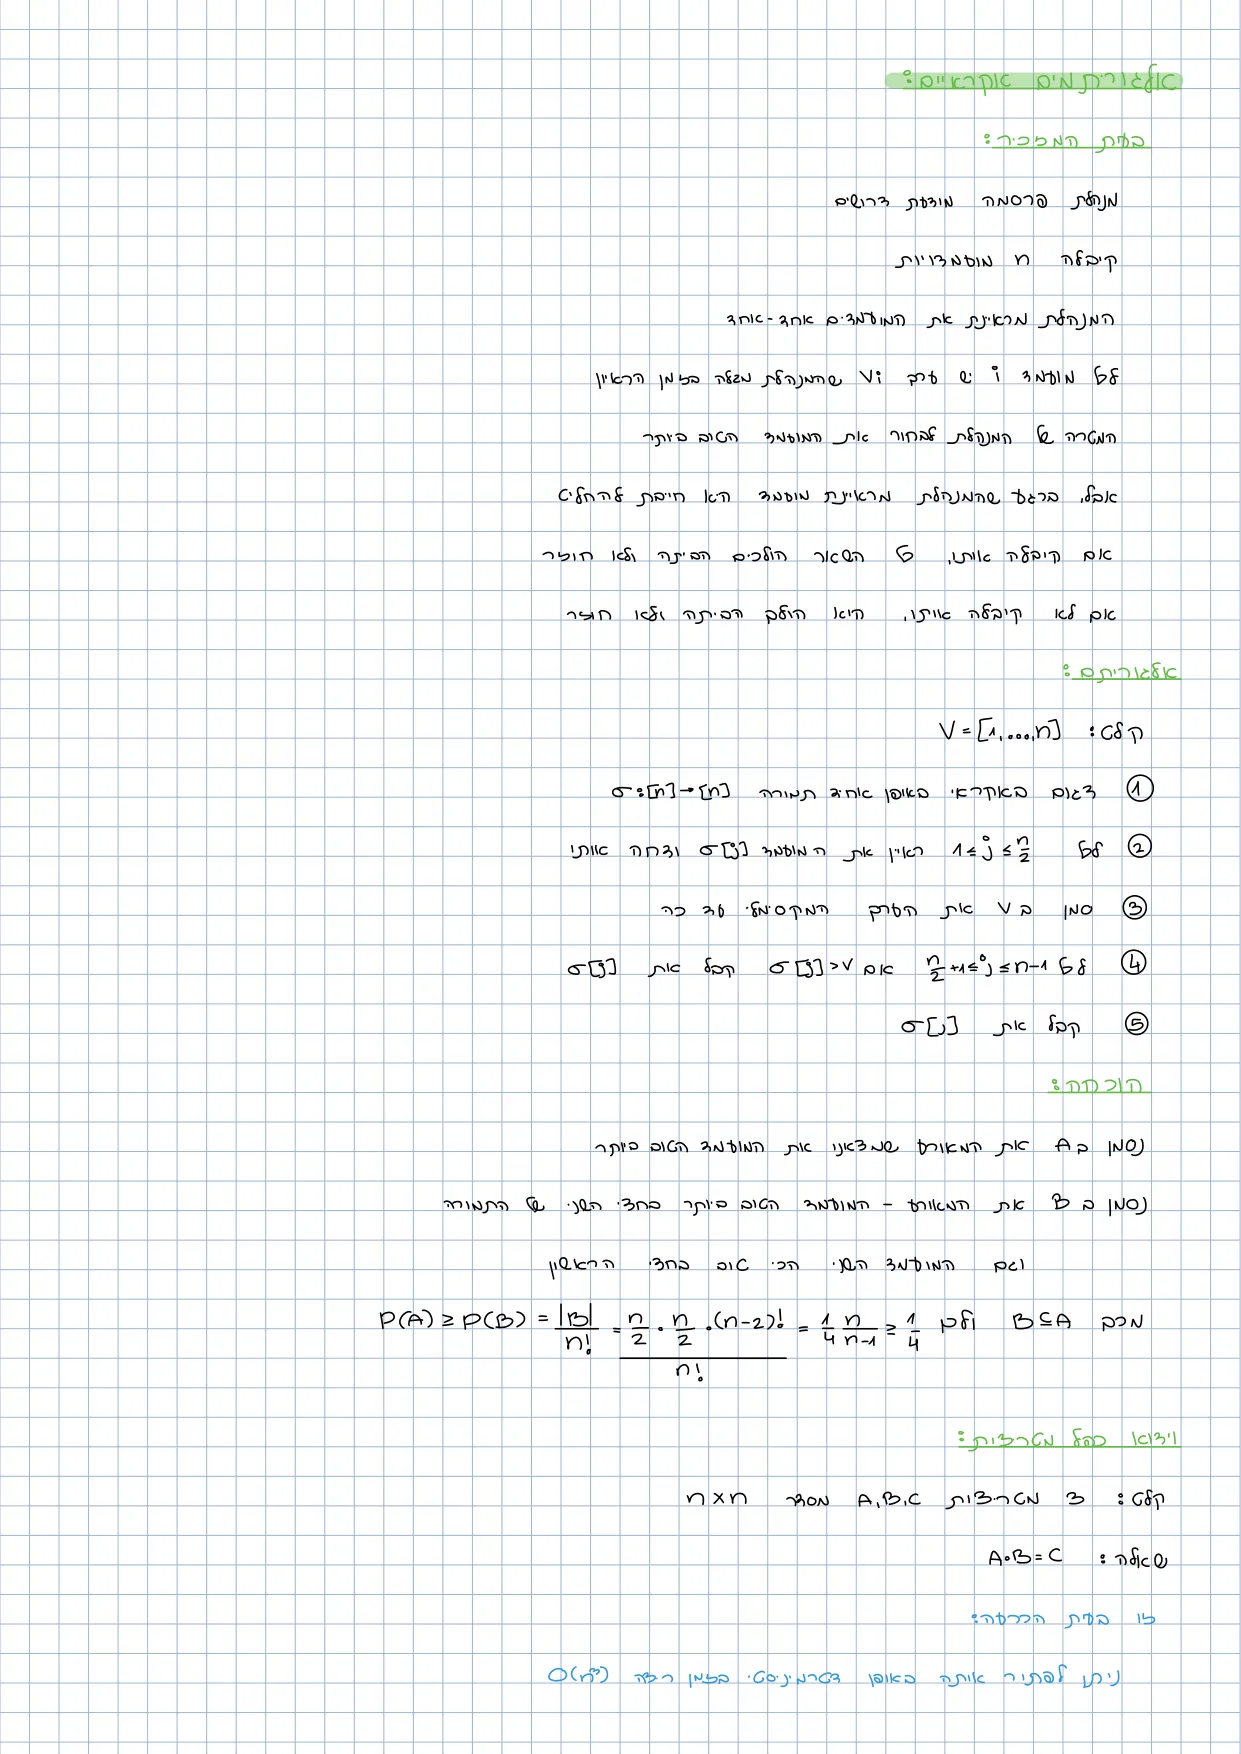
בקצרה
- אלגוריתם אקראי הוא אלגוריתם שרשאי, בנוסף לקלט, להטיל מטבעות הוגנים ובלתי תלויים ולהשתמש בתוצאתם. כל טענה הסתברותית בשיעור הזה נלקחת אך ורק על המטבעות של האלגוריתם — הקלט נשאר שרירותי, נבחר על ידי "אויב אכזר" שמכיר את קוד האלגוריתם אך לא את תוצאות ההטלות, והערובה נדרשת לכל קלט, לא לקלט אקראי. זו הנקודה שהכי קל להתבלבל בה, וזה הדבר היחיד שחייבים לקחת מהשיעור אם לוקחים ממנו דבר אחד.
- בעיית המזכיר מדגימה מדוע אקראיות עוזרת בכלל: לכל אלגוריתם דטרמיניסטי קיים קלט שעליו הוא נכשל באופן קטסטרופלי, בעוד אלגוריתם אקראי פשוט מוצא את המועמד הטוב ביותר בהסתברות על כל קלט.
- אלגוריתם Freivalds לווידוא רץ בזמן במקום ומחזיר תשובה נכונה בהסתברות ; הטעות שלו היא חד-צדדית — הוא לעולם לא דוחה קלט נכון.
- הגברה (amplification): הרצות בלתי תלויות עם קבלה רק אם כל ההרצות קיבלו מורידות את הסתברות הטעות ל- במחיר זמן ריצה . גורם ליניארי בזמן קונה ירידה אקספוננציאלית בשגיאה. עם מקבלים זמן ושגיאה .
- כל ההסתברויות בשיעור מוכחות בספירה קומבינטורית מפורשת על מרחב המדגם, ולא נטענות. מרחב המדגם הוא אוסף תוצאות הניסוי האקראי (כל התמורות; כל הווקטורים ב-) — לא אוסף הפלטים האפשריים של האלגוריתם.
- השיעור אינו מגדיר את המודל הפורמלי ואינו מגדיר מחלקות סיבוכיות אקראיות. מכונת טיורינג אקראית והמחלקות , ו- מוגדרות בשיעור הבא; שם גם ייאמר שבעיית וידוא כפל המטריצות שייכת ל-.
- הערה על היקף: המרצה אמר במפורש ([00:00:00]) שבעיית המזכיר אינה חלק מחומר המבחן והיא מוצגת בשביל העקרונות; אלגוריתם Freivalds וההגברה כן חלק מהחומר ([00:29:45]).
רקע ותלויות
מהיכן הגענו לכאן. שיעורים 12–14 עסקו בהתמודדות עם קושי חישובי דרך אלגוריתמי קירוב: כאשר בעיה היא NP-hard, במקום לוותר על יעילות מוותרים על אופטימליות ומסתפקים בערובה על יחס הקירוב. השיעור הזה פותח כלי שני מאותה משפחה — ויתור על ודאות במקום ויתור על איכות. המרצה הדגיש ([00:00:00], [00:34:34]) ששני האלגוריתמים שיוצגו כאן אינם קשורים כלל לבעיות NP-קשות; שילוב האקראיות עם אלגוריתמי קירוב יגיע בהמשך.
הסתברות בדידה — כל מה שנשתמש בו. אלה הכלים היחידים הנדרשים, וכולם מהקורס המקדים:
- מרחב מדגם הוא אוסף התוצאות האפשריות של ניסוי אקראי. מאורע הוא תת-קבוצה .
- אם הדגימה אחידה מ- סופי, אז . כלומר חישוב הסתברות מתחת להתפלגות אחידה הוא בדיוק תרגיל בקומבינטוריקה ([00:27:02]).
- מונוטוניות: אם אז . זהו הכלי שבו נחסום הסתברויות משני הכיוונים: פעם אחת כדי לחסום מלמטה הסתברות הצלחה (משפט 2), ופעם אחת כדי לחסום מלמעלה הסתברות כישלון (משפט 3).
- אי-תלות: מאורעות בלתי תלויים אם . אצלנו אי-התלות לעולם אינה מונחת — היא נבנית בכך שכל הרצה משתמשת בהטלות מטבע טריות.
- ספירה: מספר התמורות של הוא ; מספר הווקטורים ב- הוא .
המרצה ביקש במפורש ([00:31:20], [01:21:06]) לחזור לקראת השיעור הבא על תוחלת, ליניאריות התוחלת ופירוק לאינדיקטורים. בשיעור הזה תוחלת מופיעה רק בהערה אחת קצרה (מסקנה 2.1).
אלגברה ליניארית. לכל מטריצות מסדר ולכל וקטור :
הזהות הראשונה (אסוציאטיביות) היא לב האלגוריתם של Freivalds; השנייה (דיסטריביוטיביות) היא לב הניתוח. כמו כן, הקואורדינטה ה- של היא
חישוב מכפלת מטריצה בווקטור עולה פעולות אריתמטיות; חישוב מכפלת מטריצה במטריצה בשיטה הנאיבית עולה . בהקלטה [00:35:46] עלה שקיימים אלגוריתמים מהירים יותר לכפל מטריצות (מעריך כ-), אך הקורס לא נכנס לזה ומשווה מול .
המקרה הגרוע ביותר והאויב האכזר. מקורס האלגוריתמים: ניתוח במקרה הגרוע ביותר שקול לחשוב על יריב שמכיר את האלגוריתם ובוחר עבורו את הקלט המזיק ביותר ([00:07:06]). ההבדל המרכזי שנוסף כאן: היריב מכיר את הקוד, אך לא את תוצאות ההטלות, שנבחרות אחרי שהקלט כבר נקבע ([00:08:08]). זהו כל ההסבר לשאלה "למה אקראיות עוזרת".
הגדרות
הגדרה 1: אלגוריתם אקראי
ניסוח. אלגוריתם אקראי מקבל שני קלטים: את הקלט "האמיתי" , ומחרוזת ביטים שכל ביט בה נדגם באופן אחיד ובלתי תלוי מ-. בהינתן ו-, הריצה של דטרמיניסטית לחלוטין, והפלט הוא פונקציה . כל אמירה הסתברותית על היא אמירה על
אינטואיציה. תחשבו על כעל דבר שנתון לנו מבחוץ, ועל כעל הדבר היחיד שאנחנו מגרילים. המרצה ניסח זאת פעמיים ([00:11:18], [00:16:35]): "האקראיות לא תגיע לי מהקלט. הקלט הוא שרירותי, אני חושב על הקלט הגרוע ביותר, האלגוריתם הוא זה שאקראי". הניסוח האינטואיטיבי שהמרצה נתן בפתיחה ([00:00:34]) הוא: אלגוריתם אקראי הוא אלגוריתם שיכול, בכל רגע ובכמה פעמים שירצה, "לדגום באקראי ביט ", בלתי תלוי בקודמים.
מופע. האלגוריתם של Freivalds (הגדרה 5 להלן) דוגם וקטור ; זהו בדיוק ביטים אקראיים.
אי-מופע (חשוב). משפט מהצורה " הוא המועמד הטוב ביותר" אינו מאורע אקראי בהקשר הזה, כי הוא תלוי רק בקלט ולא ב-. המרצה עצר על כך במפורש ([00:20:16]): "לא לדבר על הסתברות של משהו שהוא לא אקראי — זה חסר משמעות". לעומת זאת " הוא המועמד הטוב ביותר" כן מאורע אקראי, כי הוא האובייקט שהוגרל.
הערה (מינוח שלא נאמר בשיעור): בספרות מבחינים בין אלגוריתם Las Vegas — תמיד מחזיר תשובה נכונה, וזמן הריצה שלו הוא משתנה מקרי — לבין אלגוריתם Monte Carlo — זמן הריצה חסום תמיד, אך התשובה עשויה להיות שגויה בהסתברות קטנה. שני האלגוריתמים בשיעור הזה הם מטיפוס Monte Carlo: זמן הריצה שלהם חסום בוודאות והתשובה עשויה להיות שגויה. המונחים האלה אינם מופיעים לא בסיכום ולא בהקלטה, והם נכתבים כאן רק כדי לקשר לחומר חיצוני.
הגדרה 2: מרחב המדגם של ריצה אקראית
ניסוח. מרחב המדגם של אלגוריתם אקראי הוא אוסף תוצאות הניסוי האקראי שהאלגוריתם מבצע — לא אוסף הפלטים האפשריים שלו.
אינטואיציה ומדוע זה קריטי. זו הייתה שאלת סטודנטית שהמרצה ציין כשאלה מצוינת ([00:23:52]), כי כאן נופלים הכי הרבה. באלגוריתם המזכיר הניסוי הוא "הגרלת תמורה", ולכן , קבוצת כל התמורות , ו-. לא , שהיא קבוצת הפלטים. באלגוריתם Freivalds הניסוי הוא "הגרלת וקטור", ולכן ו-.
מופע ואי-מופע (הדוגמה שהמרצה נתן, [00:24:55]). מטילים שתי קוביות הוגנות ושואלים מה ההסתברות שהסכום הוא . מרחב המדגם הוא
כלומר זוגות סדורים. תשובה שגויה נפוצה היא ש- הוא קבוצת הסכומים האפשריים — אבל הסכום הוא מאורע, לא תוצאה של הניסוי. הפתרון המלא מופיע בסעיף הדוגמאות.
הגדרה 3: טעות חד-צדדית, ומטריצת הבלבול
ניסוח. נתבונן באלגוריתם הכרעה אקראי לשפה . לכל קלט מוגדרים שני סוגי טעות:
| האלגוריתם מקבל | האלגוריתם דוחה | |
|---|---|---|
| (yes-instance) | נכון | false negative |
| (no-instance) | false positive | נכון |
זוהי מטריצת הבלבול (confusion matrix) של האלגוריתם ([01:02:43]). לאלגוריתם יש טעות חד-צדדית אם אחת משתי משבצות הטעות ריקה — כלומר הוא יכול לטעות רק לכיוון אחד. אם שתיהן אפשריות, הטעות דו-צדדית.
אינטואיציה. אין תשובה כללית לשאלה איזו טעות גרועה יותר — זה תלוי ביישום ([01:03:14]): בבדיקה אפידמיולוגית עדיף false positive (מישהו יישאר בבית לחינם) על false negative; לפני ניתוח מוח לא רוצים אף אחד מהם.
מופע. אלגוריתם Freivalds: כאשר הוא תמיד מקבל, ולכן אין לו false negative כלל — טעות חד-צדדית מסוג false positive בלבד ([01:03:46]). זו בדיוק התכונה שתאפשר את ההגברה הפשוטה במשפט 4.
אי-מופע. אלגוריתם שמכריע לפי הצבעת רוב על הרצות שכל אחת מהן טועה בהסתברות בשני הכיוונים הוא בעל טעות דו-צדדית. גם אותו אפשר להגביר, אך לא בכלל "קבל רק אם כולם קיבלו" אלא בהצבעת רוב; המרצה ציין זאת ([01:04:52]) והשאיר לשיעור הבא.
הגדרה 4: בעיית המזכיר (Secretary Problem)
ניסוח (המודל). נתונים מועמדים, , שלמועמד ערך ממשי . הערכים שונים זה מזה ו- זוגי (ראו פערים). המועמדים מרואיינים אחד-אחד, בסדר שהאלגוריתם קובע. הכללים:
- הערך מתגלה רק בזמן הראיון של מועמד , ולא לפניו.
- מיד בתום הראיון יש להחליט: לקבל או לדחות.
- אם קיבלנו — התהליך נעצר, שאר המועמדים הולכים הביתה.
- אם דחינו — המועמד הולך הביתה ולא ניתן לחזור אליו.
המטרה: לבחור את המועמד בעל הערך המקסימלי.
אינטואיציה. בלי כללים 1–4 זו בעיית "מציאת מקסימום במערך", והאלגוריתם המוכר (שמור את המקסימום עד כה, החלף אם ראית גדול יותר) פותר אותה בוודאות ([00:04:56]). הכללים הופכים את הקלט ממערך לרשימה מקושרת חד-כיוונית שאי אפשר לחזור בה אחורה ([00:14:29]) — מה שנקרא היום בעיה online. כל הקושי נובע מכך שההחלטה חייבת להתקבל לפני שנראתה יתרת הקלט.
מופע. עם ערכים : המועמד הטוב ביותר הוא (ערך ), השני הכי טוב הוא (ערך ).
אי-מופע (מה שאינו הבעיה). "לבחור את המקסימום מתוך מערך נתון" — שם אין החלטה בלתי הפיכה, ולכן אין קושי.
הגדרה 5: וידוא כפל מטריצות ואלגוריתם Freivalds
ניסוח הבעיה. הקלט הוא שלוש מטריצות מסדר , והשאלה היא האם . זו בעיית הכרעה ("בעיית אחר?" — כן/לא), והיא אינה NP-קשה: אפשר לפתור אותה דטרמיניסטית בזמן פשוט על ידי חישוב והשוואה ל-. נסמן את השפה ב- (סימון שלנו; בסיכום הבעיה אינה מקבלת שם).
המטרה אינה להוציא את הבעיה מ- — היא כבר שם — אלא להוריד את המעריך ([00:36:51]).
האלגוריתם (Freivalds). על קלט :
- בחר באקראי, באופן אחיד, וקטור .
- חשב ו-.
- אם — קבל; אחרת — דחה.
אינטואיציה. במקום להשוות שתי מטריצות (יקר), משווים את פעולתן על וקטור אקראי אחד (זול). ההצדקה לזמן הריצה היא האסוציאטיביות : אף פעם לא כופלים מטריצה במטריצה, רק מטריצה בווקטור ([00:38:59]).
מופע ואי-מופע. אם אז לכל ההשוואה מצליחה. אם עדיין ייתכנו וקטורים ספציפיים שעבורם — מהאלגברה הליניארית ידוע ששתי מטריצות שונות יכולות להסכים על וקטור מסוים ([00:43:20]). כל מה שצריך להוכיח הוא שאין יותר מדי כאלה.
משפטים והוכחות
משפט 1: אין אלגוריתם דטרמיניסטי עם ערובה כלשהי לבעיית המזכיר
ניסוח. לכל אלגוריתם דטרמיניסטי לבעיית המזכיר קיים קלט (סדרת ערכים) שעליו מחזיר את המועמד בעל הערך הנמוך ביותר. בפרט, לכל קיים קלט שעליו הערך שנבחר קטן מ- כפול המקסימום.
הוכחה. נבנה יריב שמייצר את הערכים תוך כדי ריצה. הנקודה המרכזית: מאחר ש- דטרמיניסטי, ההחלטה שלו בשלב היא פונקציה של הרישא בלבד. לכן אם היריב שינה רק ערכים שטרם נחשפו, התנהגות על הרישא אינה משתנה.
היריב מזין ערכים עולים: . נבחין בשני מקרים.
מקרה א': מקבל בשלב כלשהו . בזמן הזה הוא ראה רק את . עכשיו היריב "משנה את דעתו" לגבי ההמשך וקובע עבור גדול כרצוננו. הרישא לא השתנתה, ולכן עדיין מקבל בשלב ומחזיר ערך , בעוד המקסימום הוא . היחס קטן מכל עבור גדול מספיק. אם בפרט , המועמד שנבחר הוא גם בעל הערך הנמוך ביותר.
מקרה ב': דוחה את כל הראשונים. אז הוא חייב לקחת את המועמד האחרון (או להחזיר כלום, מה שגרוע אף יותר). היריב קובע כעת , כלומר הנמוך מכולם. שוב הרישא לא השתנתה, ולכן ההתנהגות זהה, ו- מחזיר את הגרוע ביותר.
הערה: בהרצה זה נאמר בקיצור — "לכל אלגוריתם דטרמיניסטי אני יכול לייצר קלט שבו הוא יבחר לא נכון... יותר מזה, אני יכול לדאוג שהוא ימצא מועמד ממש גרוע" ([00:05:28]–[00:06:33]) — בלי לפרט את שני המקרים. הפירוט כאן.
מדוע הניסיון הנאיבי לאקראיות אינו עוזר. סטודנט הציע ([00:07:06]) להגריל את הסף: לצפות במספר אקראי של מועמדים ואז לקחת את הראשון שעובר את המקסימום שנצפה. המרצה הראה מיד שזה נכשל: היריב פשוט ישים את המועמד הטוב ביותר במקום הראשון. אז לא משנה מה הסף שהוגרל (כל עוד הוא לפחות ), המועמד הטוב ביותר נמצא בשלב התצפית ונדחה בוודאות, ולכן קיים קלט שעליו האלגוריתם טועה בהסתברות . המסקנה, שהיא הלקח האמיתי של המשפט: לא מספיק "להוסיף אקראיות" — צריך להוסיף אותה במקום הנכון, כלומר לטשטש בדיוק את הדבר שהיריב שולט בו. היריב שולט בסדר, ולכן את הסדר צריך להגריל ([00:09:42]).
משפט 2: האלגוריתם האקראי לבעיית המזכיר
האלגוריתם. על קלט של מועמדים ( זוגי, ערכים שונים):
- הגרל תמורה באופן אחיד מתוך כל התמורות.
- לכל : ראיין את המועמד ודחה אותו.
- סמן ב- את הערך המקסימלי שנצפה עד כה, כלומר .
- לכל : אם אז קבל את ועצור.
- אם הגעת לכאן — קבל את .
ניסוח המשפט. לכל קלט (כלומר לכל וקטור ערכים שונים ), אם הוא המאורע "האלגוריתם מחזיר את המועמד בעל הערך המקסימלי", אז
ההסתברות נלקחת רק על התמורה , והחסם תקף לכל קלט.
למה שלב 5 קיים. שאלת סטודנט ([00:17:06]): מדוע הלולאה בשלב 4 נעצרת ב-? כי כאשר מגיעים למועמד האחרון אין עוד ברירה — חייבים לקבל אותו, בלי תנאי. אלמלא שלב 5 האלגוריתם היה עלול לא להחזיר דבר ([00:12:22]).
הוכחה. ראשית נשים לב לנקודה המתודולוגית: לאחר שהוגרלה , כל שאר הריצה דטרמיניסטית ([00:19:45]). לכן כל מאורע שאנחנו מגדירים חייב להיות פונקציה של בלבד, ומרחב המדגם הוא עם .
נגדיר מאורע שני:
כלומר: התמורה שמה את המועמד הטוב ביותר איפשהו בחצי השני, ואת השני-הכי-טוב איפשהו בחצי הראשון.
שלב 1: . נניח ש- מתרחש. המועמד השני-הכי-טוב נמצא בחצי הראשון, והמועמד הטוב ביותר אינו שם; לכן המקסימום של החצי הראשון הוא בדיוק ערכו של השני-הכי-טוב, כלומר (כאן הם הערכים בסדר יורד). כעת בחצי השני: המועמד היחיד בכל הקלט שערכו גדול מ- הוא המועמד הטוב ביותר. לכן בשלב 4 האלגוריתם דוחה כל מי שאינו הטוב ביותר, ומקבל אותו ברגע שהוא מגיע אליו. שני מקרי קצה:
- אם הטוב ביותר יושב במקום עבור — הוא ייבחר בשלב 4.
- אם הטוב ביותר יושב דווקא במקום — אז שלב 4 לא קיבל אף אחד (איש לא עבר את ), ושלב 5 מקבל את , שהוא הטוב ביותר.
בשני המקרים האלגוריתם מחזיר את הטוב ביותר, כלומר מתרחש. לכן כקבוצות של תמורות. מכאן, לפי מונוטוניות, ([00:22:19]).
שלב 2: ספירת . נבנה תמורה ב- בשלושה שלבים בלתי תלויים:
- בוחרים מקום לשני-הכי-טוב בחצי הראשון: אפשרויות.
- בוחרים מקום לטוב ביותר בחצי השני: אפשרויות.
- מסדרים את הנותרים ב- המקומות הנותרים: אפשרויות.
כל תמורה ב- מתקבלת בדיוק פעם אחת בבנייה הזאת, ולכן
שלב 3: החשבון. מאחר שהדגימה אחידה,
נשתמש ב-, כלומר , ונקבל
שכן לכל . בשילוב עם שלב 1: .
מסקנה 2.1 (תוחלת). לכל קלט, הערך של המועמד שנבחר מקיים בתוחלת
כלומר לפחות רבע מהמקסימום. הנימוק: כל הערכים אי-שליליים, ולכן התוחלת חסומה מלמטה על ידי התרומה של המאורע בלבד. המרצה ציין זאת ב-[00:31:20] בלי חישוב; זהו החישוב.
מדוע אינו "גרוע" (שאלת סטודנט, [00:29:45]–[00:30:50]). יש להשוות למשפט 1, לא ל-. דטרמיניסטית אין שום ערובה — קיים קלט שעליו הכישלון ודאי. כאן מתקבל לכל קלט, כולל הגרוע ביותר; האקראיות "פיזרה את הסיכון". יתרה מזו, אם מחליפים את הסף ב- מקבלים הסתברות הצלחה , וזהו האופטימום — אין אלגוריתם טוב יותר ([00:12:54], [00:17:38]). הבחירה ב- נעשתה רק כדי שההוכחה תהיה בת שלוש שורות.
משפט 3: נכונות וזמן ריצה של אלגוריתם Freivalds
ניסוח. יהיו מטריצות קבועות (חלק מהקלט, לא אקראיות). האלגוריתם של הגדרה 5 רץ בזמן פעולות אריתמטיות ומקיים:
- אם אז ;
- אם אז , ולכן .
ההסתברות נלקחת רק על , והחסם תקף לכל שלשת מטריצות.
הערה מתודולוגית חשובה ([00:41:47]–[00:42:19]): אסור לכתוב "" בלי לפצל למקרים. הפיצול ל-yes-instance ו-no-instance הוא פיצול לפי הקלט, והקלט אינו אקראי; לכן הוא חייב להיעשות מחוץ לסימן ההסתברות. זו טעות נפוצה למבחן.
זמן ריצה. מחשבים ( כפלים), אחר כך (שוב , כי זו מטריצה כפול וקטור), ובנפרד (), ולבסוף משווים שני וקטורים באורך (). סך הכול . הנקודה: בזכות האסוציאטיביות לעולם לא מבצעים כפל מטריצה במטריצה ([00:38:59]).
הוכחת סעיף 1 (שלמות). נניח . אז לכל בלי יוצא מן הכלל מתקיים , ולכן התנאי בשלב 3 מתקיים והאלגוריתם מקבל. זהו מאורע שמכיל את כל , ולכן הסתברותו . שימו לב שכאן לא נעשה שום שימוש באקראיות — הטענה נכונה פוינטווייז לכל .
הוכחת סעיף 2 (נאותות). נניח ונסמן
צעד א' — תרגום תנאי הקבלה. מדיסטריביוטיביות, אם ורק אם אם ורק אם . לכן
צעד ב' — בחירת איבר לא אפסי. מאחר ש-, יש בה לפחות איבר אחד שונה מאפס. ללא הגבלת הכלליות נניח שזהו . הבחירה הזו לגיטימית בתוך חישוב הסתברות משום ש- (ולכן ) אינן אקראיות — האינדקסים נקבעים לפני ההגרלה ואינם תלויים ב-. אילו היה מדובר באיבר כללי, ההוכחה הייתה זהה מילה במילה עם גרירת שני אינדקסים ([00:45:29]).
צעד ג' — מעבר לקואורדינטה אחת. מתקיימת הכלת מאורעות: אם הוא וקטור האפס אז בפרט הקואורדינטה הראשונה שלו אפס. כלומר
ולכן, ממונוטוניות, וזה הכיוון הנכון כי אנחנו חוסמים מלמעלה ([00:48:43]):
צעד ד' — בידוד . מעבירים אגפים ומבודדים:
החלוקה חוקית בדיוק משום שדאגנו ש-; זו כל המטרה של צעד ב' ([00:53:37]).
צעד ה' — ספירה. מרחב המדגם הוא עם , בהתפלגות אחידה. נספור כמה וקטורים מקיימים את השוויון האחרון. נקבע ערכים כלשהם ל-; יש קביעות כאלה. עבור כל קביעה, האגף הימני הוא מספר קבוע , ולכן קיים לכל היותר ערך אחד של שמקיים את השוויון: אם יש בדיוק אפשרות אחת, ואם (למשל או לא שלם או אפילו אי-רציונלי) אין אף אפשרות ([00:55:47], [00:56:19]). לכן
ומכאן
האופן שבו כדאי לחשוב על צעד ה'. הם "משתנים חופשיים" ו- הוא "משתנה תלוי" שנקבע (לכל היותר) על ידם ([01:00:36]). זהו בדיוק תרגיל ספירה, לא טיעון הסתברותי עמוק.
מסקנה 3.1 (טעות חד-צדדית). לפי סעיף 1 אין לאלגוריתם false negative כלל: הוא לעולם אינו דוחה קלט שבו . לכן כל הטעות שלו היא false positive, והיא חד-צדדית ([01:03:46]). זו התכונה שמפעילה את משפט 4.
משפט 4: הגברה בשתי חזרות
האלגוריתם המשופר. על קלט :
- הרץ את האלגוריתם של הגדרה 5 פעמיים, כל פעם עם הגרלה טרייה ובלתי תלויה של .
- אם בשתי ההרצות האלגוריתם קיבל — קבל; אחרת — דחה.
ניסוח. אם אז ; אם אז , ולכן . זמן הריצה נשאר אסימפטוטית.
הוכחה. יהיו המאורעות "ההרצה הראשונה קיבלה" ו"ההרצה השנייה קיבלה".
מקרה : לפי משפט 3.1, , ולכן שתי ההרצות מקבלות בוודאות והאלגוריתם המשופר מקבל בהסתברות . זה בדיוק מה שהטעות החד-צדדית קונה לנו: הצד הזה לא נפגע מהחזרה ([01:12:25]).
מקרה : לפי הגדרת האלגוריתם, האלגוריתם המשופר מקבל אם ורק אם וגם . המאורעות בלתי תלויים, כי הם פונקציות של שתי מחרוזות אקראיות נפרדות שהוגרלו באופן בלתי תלוי — אי-התלות אינה הנחה, היא מובנית באלגוריתם ([01:06:25]). לכן
ומכאן .
הערה על שם התהליך: מרגע שנאמר "באופן בלתי תלוי", אפשר לחשוב על שתי ההרצות כאילו נעשו במקביל; זה נקרא גם parallel repetition ([01:06:25]).
משפט 5: הגברה כללית ל- חזרות
האלגוריתם. על קלט :
- הרץ את האלגוריתם של הגדרה 5 פעמים עם הגרלות טריות ובלתי תלויות.
- קבל אם ורק אם בכל ההרצות האלגוריתם קיבל.
ניסוח. זמן הריצה הוא , ולכל :
- אם : ;
- אם : , ולכן .
הוכחה. זמן הריצה: הרצות של כל אחת. שימו לב ש- עצמו רשאי להיות פונקציה של , ולכן הגורם נשאר מפורש בחסם ([01:11:39]).
נכונות במקרה : כל הרצה מקבלת בהסתברות (משפט 3.1), ולכן חיתוך של מאורעות ודאיים הוא מאורע ודאי.
נכונות במקרה : יהי המאורע "ההרצה ה- קיבלה". המאורעות בלתי תלויים, שכן כל אחד מהם תלוי בבלוק ביטים אקראיים נפרד וזר לאחרים. האלגוריתם מקבל אם ורק אם , ולכן
המקרה המעניין: (בסיס ). אז
זהו הלקח הכמותי המרכזי של השיעור ([01:15:16]): גורם ליניארי בזמן הריצה קונה ירידה אקספוננציאלית בהסתברות הכישלון, וזה בדיוק בגלל שהסתברויות של מאורעות בלתי תלויים מוכפלות. ככל ש- גדל, הסתברות ההצלחה שואפת ל-.
מסקנה 5.1 (טרייד-אוף). יש כאן שתי מטרות מתחרות ([01:10:37]): הגדלת משפרת את הסתברות ההצלחה אך מגדילה את זמן הריצה, וגם צורכת יותר ביטים אקראיים ( במקום ). אין ערך "נכון" ל- — הוא נקבע לפי היישום.
משפט 6: הגרלה מאלפבית גדול יותר, וחשבון הביטים
רקע. שאלת סטודנט ([01:14:05]): למה להגריל מ- ולא מ-?
ניסוח. נריץ את האלגוריתם של הגדרה 5 כאשר נדגם באופן אחיד מ- עבור . אז אם מתקיים .
הוכחה. ההוכחה של משפט 3 עוברת מילה במילה עד צעד ה'. שם, ; לכל קביעה של (יש כאלה) יש לכל היותר ערך אחד של שמקיים . לכן
בפרט: נותן , ו- נותן ([01:17:22]).
החשבון שמראה שזה לא בהכרח משתלם ([01:18:25]–[01:19:30]). ביטים אקראיים אמיתיים הם משאב שעולה כסף — ה-random של המחשב אינו אקראי באמת, ואם רוצים ביטים בלתי תלויים באיכות גבוהה משלמים עליהם; זה משאב שכלל לא נכלל בחשבון זמן הריצה שלנו. נשווה שתי דרכים להוציא הסתברות טעות טובה יותר מ-:
| שיטה | ביטים אקראיים | הסתברות טעות | זמן ריצה |
|---|---|---|---|
| הרצה אחת מ- | (שני ביטים לקואורדינטה) | ||
| שתי הרצות מ- |
באותו מחיר בביטים אקראיים, החזרה הכפולה על האלפבית הבינארי נותנת טעות קטנה יותר () אך משלמת פי שניים בזמן. אין כאן זוכה מוחלט — יש טרייד-אוף, וההחלטה תלויה במה יקר יותר במערכת הספציפית (זמן מעבד, ביטים אקראיים, זמן מתכנתים). המרצה סיכם: "זה כמו פלסטלינה, צריך לשחק עם זה".
הערה נוספת: הבחירה ב- בהוכחה המקורית נעשתה מסיבה דידקטית בלבד — כך היה קל למנות את כל האפשרויות על הלוח ([01:17:22]).
דוגמאות ותרגילים מהשיעור
דוגמה 1: שתי קוביות — תרגיל החימום על מרחב מדגם
השאלה ([00:24:55]). מטילים שתי קוביות הוגנות. מה ההסתברות שהסכום הוא ?
פתרון מלא. מרחב המדגם הוא אוסף התוצאות של הניסוי, כלומר זוגות סדורים:
ההתפלגות אחידה על הזוגות. המאורע המבוקש הוא
לכן .
הלקח. התשובה הנפוצה והשגויה היא ש- ולכן ההסתברות היא . הסכום הוא מאורע, לא תוצאת ניסוי; אילו היה מרחב המדגם, כל הסכומים היו שווי הסתברות, וזה שקר. אותה בדיוק טעות ממתינה בבעיית המזכיר: מרחב המדגם הוא ולא .
דוגמה 2: מעקב מלא אחר אלגוריתם המזכיר עבור
הקלט. , ערכים . הטוב ביותר: מועמד (ערך ). השני-הכי-טוב: מועמד (ערך ).
האלגוריתם על הקלט הזה. מגרילים מתוך תמורות; מראיינים ודוחים את וקובעים ; בשלב מקבלים אם ; אחרת מקבלים את .
החסם מהמשפט. , ולכן , בהתאמה מלאה לנוסחה .
חישוב מדויק של (מעבר לנדרש, כדי לראות שההכלה ממש). נסמן את דירוגי המועמדים (הטוב ביותר) עד (הגרוע ביותר) ונספור לפי מיקום הטוב ביותר בתמורה:
- הטוב ביותר במקום : אז תמיד, והאלגוריתם מקבל אותו. הצלחה. מספר תמורות: .
- הטוב ביותר במקום : מצליחים אם ורק אם המועמד במקום אינו עובר את , כלומר אם הוא אינו הטוב מבין השלושה הראשונים. שלושת המקומות הראשונים מכילים את הדירוגים ב- סידורים; הכישלון הוא בדיוק כאשר דירוג יושב במקום , וזה קורה ב- סידורים. לכן הצלחות.
- הטוב ביותר במקום או במקום : אז שווה לערך המקסימלי בכל הקלט, איש בחצי השני לא יעבור אותו, והאלגוריתם ייקח את שאינו הטוב ביותר. כישלון בכל התמורות.
סך הצלחות: , כלומר
ואכן . ההכלה אמיתית וממש — יש הצלחות שאינן ב- (למשל: הטוב ביותר במקום בעוד השני-הכי-טוב במקום ) — ולכן החסם אינו הדוק, אבל הוא זול מאוד להוכחה.
דוגמה 3: מעקב מלא אחר Freivalds, כולל מקרה שבו החסם הדוק
ניקח
מקרה yes-instance. אם אז לכל אחד מארבעת הווקטורים מתקיים , והאלגוריתם מקבל. , כמובטח.
מקרה no-instance. ניקח , שנבדל מ- רק באיבר . אז
כאן , ולכן ה"ללא הגבלת הכלליות" של ההוכחה מחייב לבחור את האיבר הלא-אפסי ולהריץ את הטיעון על השורה השנייה — בדיוק כפי שנאמר בהקלטה שהיה קורה עם אינדקסים כלליים ([00:45:29]).
נבדוק את ארבעת הווקטורים ידנית:
| החלטה | נכונות | |||
|---|---|---|---|---|
| קבל | טעות (false positive) | |||
| קבל | טעות (false positive) | |||
| דחה | נכון | |||
| דחה | נכון |
לכן בדיוק — הדוגמה מראה שהחסם של משפט 3 הדוק ואי אפשר לשפרו במקרה הגרוע. ואכן, לפי הניתוח: , שמתאפס אם ורק אם , ויש וקטורים כאלה מתוך .
מה עושה ההגברה כאן. על אותו קלט, הרצות בלתי תלויות טועות רק אם בכל ההרצות הוגרל , כלומר בהסתברות בדיוק — התאמה מושלמת למשפט 5.
דוגמה 4: החשבון הכמותי שמצדיק את כל התרגיל
ניקח ו-:
- דטרמיניסטי נאיבי: פעולות, תשובה ודאית.
- Freivalds עם : פעולות — חיסכון של פי — והסתברות טעות , וגם זו רק לכיוון אחד.
זהו הטיעון המלא לטובת האלגוריתם: מוותרים על ודאות מוחלטת תמורת שיפור של סדר גודל בזמן, ומחיר הוויתור יורד אקספוננציאלית בעוד המחיר בזמן עולה רק ליניארית.
תרגיל (נשאל בכיתה, [01:14:05]) — פתרון מלא
השאלה. מה קורה אם דוגמים מ- במקום מ-, והאם זה עדיף?
פתרון. לפי משפט 6, הסתברות הטעות יורדת ל-. אבל צריך לספור ביטים אקראיים: כל קואורדינטה ב- דורשת שני ביטים, כלומר ביטים לעומת . באותם ביטים אפשר במקום זאת להריץ פעמיים את הגרסה הבינארית ולקבל טעות , שהיא טובה יותר מ- — במחיר של פי שניים בזמן הריצה. מסקנה: מבחינת ניצול ביטים אקראיים, חזרה על האלגוריתם הבינארי עדיפה; מבחינת זמן ריצה, האלפבית הגדול עדיף. אין תשובה אחת נכונה — יש טרייד-אוף.
הערות מהשיעור
- [00:00:00] היקף למבחן. בעיית המזכיר "אינה למבחן ואינה חלק מהחומר של הקורס" — המרצה מציג אותה כי היא מדגימה בדיוק את העקרונות שיחזרו בכל השיעור: הקלט הגרוע ביותר, האויב האכזר, מה אקראי ומה שרירותי, ומהו מרחב המדגם. לעומת זאת, מ-[00:29:45] ואילך ("אלגוריתם שהוא כבר כן חלק מהקורס") החומר הוא חומר מבחן מלא.
- [00:08:08] הסדר שבו הדברים נקבעים. "אני מכיר את האלגוריתם שלך כשאני בונה את הקלט, אבל האקראיות נבחרת אחר כך." זו כל הסיבה שאקראיות עוזרת. אם האויב היה רואה גם את המטבעות, לא היה יתרון.
- [00:10:47] מאיפה מגיעה האקראיות. סטודנט שאל מה ההבדל בין "המנהלת מראיינת בסדר אקראי" לבין "המועמדים מגיעים בסדר אקראי". התשובה: הבדל מהותי. הקלט מגיע בסדר שרירותי ואיננו שולטים בו; רק המנהלת רשאית לערבב. הנחה על התפלגות הקלט היא הנחה שאין לנו זכות להניח.
- [00:20:16] מאורעות חייבים להיות פונקציה של האקראיות. " הוא הטוב ביותר" אינו מאורע אקראי; " הוא הטוב ביותר" כן. אין משמעות להסתברות של דבר שאינו אקראי. שווה לבדוק את זה לפני כל חישוב הסתברות במבחן.
- [00:31:51] למה זה חשוב. שאלת סטודנט "למה צריך את זה?" קיבלה את התשובה המפורשת ביותר בשיעור: "אם אתה שואל אותי מה מכל הקורס לקחת איתך הלאה — זה החלק הזה של אלגוריתמים אקראיים." הנימוק: היום גם זמן ריצה ליניארי עשוי להיות יקר מדי; אם אין תקציב לקרוא את כל הקלט, בהכרח בודקים רק חלק ממנו — ואם בוחרים את המקומות באופן קבוע, יבוא אויב ויקלקל. לכן בוחרים אותם באקראי.
- [00:39:29] אזהרה מפני "שיפור" ריק. "להוריד את זמן הריצה זה לא חוכמה — יכולתי גם להגיד: תזרוק מטבע, יצא אפס תחזיר כן, יצא אחד תחזיר לא." העניין אינו בזמן הריצה לבדו אלא בזמן ריצה יחד עם ערובת נכונות מוכחת.
- [00:46:38] מתודולוגיה של חסמים. "יש לי הרבה יותר כלים לחסום הסתברות מלמעלה מאשר מלמטה. לכן כשאני מנתח אלגוריתם אקראי אני אחסום מלמעלה את הסתברות הכישלון, ומכך אקבל חסם מלמטה על הסתברות ההצלחה." זה מסביר למה כל הניתוח של Freivalds מנוסח על "האלגוריתם מקבל" ולא על "האלגוריתם צודק".
- [01:13:29] מבנה קבוע לניתוח. כמעט תמיד מפצלים ל-yes-instance ו-no-instance, כי האלגוריתם עשוי להתנהג אחרת לגמרי בשני המקרים — אבל זהו פיצול של הקלטים, לא של הדגימה האקראית.
- [01:17:53] ביטים אקראיים עולים כסף. ה-
randomשל המחשב אינו אקראי ואפילו לא קרוב לזה; ביטים אקראיים איכותיים ובלתי תלויים הם מוצר שמשלמים עליו. זהו משאב שהניתוח שלנו כלל לא תמחר. - [01:20:34] כמה שגיאה מותרת? אין תשובה מוחלטת: שגיאה בחלוקת עיתונים היא זניחה; שגיאה בניתוח מוח היא בלתי נסבלת. "שערה אחת על הראש זה מעט, שערה אחת במרק זה המון."
- [01:21:06] לקראת השיעור הבא. לחזור על תוחלת, ליניאריות התוחלת, ופירוק לאינדיקטורים. השיעור הבא מגדיר את המודל הפורמלי (מכונת טיורינג אקראית) ואת המחלקות; שם ייאמר ([00:40:58] בהקלטה 21) שבעיית וידוא כפל המטריצות שייכת ל-, בדיוק בגלל הטעות החד-צדדית שהוכחנו כאן.
פערים בין הסיכום להקלטה
- מקור: ההקלטה, [00:04:56]–[00:09:42]. הפער: כל הטיעון שאין אלגוריתם דטרמיניסטי עם ערובה לבעיית המזכיר, כולל טיעון האויב האכזר והניסיון הכושל להגריל את הסף, אינו מופיע בסיכום כלל. ההכרעה: נכתב כאן במלואו כמשפט 1, כולל שני מקרי היריב שנאמרו בעל-פה בקיצור.
- מקור: ההקלטה, [00:23:52]–[00:26:31]. הפער: כל הדיון במרחב המדגם ודוגמת שתי הקוביות אינם בסיכום. ההכרעה: נכתבו כהגדרה 2 וכדוגמה 1, כולל הפתרון המספרי () שלא נאמר בהקלטה.
- מקור: ההקלטה, [01:01:40]–[01:04:52]. הפער: המושגים confusion matrix, false positive/false negative וטעות חד-צדדית אינם מופיעים בסיכום, אף שהם המצדיקים את כלל ההגברה "קבל רק אם כולם קיבלו". ההכרעה: נכתבו כהגדרה 3 וכמסקנה 3.1.
- מקור: ההקלטה, [01:14:05]–[01:19:30]. הפער: ניתוח האלפבית וחשבון הביטים האקראיים אינם בסיכום. ההכרעה: נכתבו כמשפט 6 וכתרגיל בסוף סעיף הדוגמאות; ההוכחה הכללית ל- בגודל היא הכללה שלנו של הטיעון שנאמר עבור ו-.
- מקור: עמוד 1 בסיכום. הפער: האות מופיעה בשלוש משמעויות — קבוצת המועמדים (), ערכי המועמדים (), והסף המקסימלי בשלב 3. ההכרעה: הופרדו כאן ל- (המועמדים), (הערכים) ו- (הסף). זהו תיקון סימון, לא תיקון מתמטי.
- מקור: עמוד 1 בסיכום, שלב 4. הפער: נכתב "אם " — השוואה בין אינדקס לבין ערך. ההכרעה: הכוונה ברורה מן ההקשר ומההקלטה ([00:16:03]) והתנאי נכתב כאן .
- מקור: עמוד 1 בסיכום. הפער: לא נאמר ש- זוגי (אחרת אינו שלם) ולא שהערכים שונים זה מזה (אחרת "המועמד הטוב ביותר" ו"השני הכי טוב" אינם מוגדרים היטב, וההכלה עלולה להיכשל). ההכרעה: שתי ההנחות נוספו במפורש בהגדרה 4 ובמשפט 2.
- מקור: ההקלטה, [00:51:55]. הפער: על הלוח נכתב לרגע (עם בתוך הסכום); סטודנטית תיקנה והמרצה אישר "טעיתי". הסיכום כותב נכון . ההכרעה: הסיכום נכון ומופיע כאן; מדובר בפליטת לוח רגעית ולא בפער אמיתי.
- מקור: עמוד 3 בסיכום. הפער: נרשם ללא ציון בסיס. ההכרעה: פורש כ-, שכן רק כך כפי שרשום מיד אחריו ונאמר ב-[01:14:46].
- מקור: משימת הכתיבה מול שני המקורות. הפער: ההבחנה Las Vegas מול Monte Carlo אינה מופיעה בשום מקום בסיכום או בשתי ההקלטות. ההכרעה: נכתבה כהערת מינוח מסומנת בלבד, בתוך הגדרה 1, כדי לא לייחס לקורס מונחים שלא נאמרו בו.
- מקור: הסיכום וההקלטה מול המוסכמות של הסדרה. הפער: שני המקורות מדברים על "האלגוריתם" ולא על שפות ומחלקות, ולכן אין בשיעור הזה שמות מחלקות או רביעיית מכונה. ההכרעה: שמות המחלקות שכן מוזכרים בהפניות קדימה (, , , ) נכתבים לפי מוסכמת הסדרה, ולשפת וידוא כפל המטריצות ניתן כאן השם שאינו מופיע במקורות. סימוני המשתנים (, , , ) נלקחו מהסיכום.
- מקור: שם קובץ ההקלטה. הפער: הקובץ מתויג "שיעור 14" בעוד תוכנו הוא בדיוק שיעור 15 בסיכומים; ההקלטה שמתאימה לשיעור 14 (השיעור השני על קירוב) חסרה. ההכרעה: התיוג התעלם ממנו; ההקלטה מכסה את שלושת עמודי הסיכום מתחילתה ועד סופה, ואינה פותחת בחזרה על חומר הקירוב.
סיכום ונקודות למבחן
מה חייבים לזכור.
- על מה ההסתברות. בכל טענה על אלגוריתם אקראי, ההסתברות היא על המטבעות של האלגוריתם בלבד, לקלט קבוע ושרירותי, והערובה נדרשת לכל קלט. "בהסתברות " פירושו: לכל קלט, לפחות רבע מהגרלות מובילות להצלחה. זה לא אומר "לרבע מהקלטים", ולא אומר משהו על קלט אקראי.
- בעיית המזכיר: דטרמיניסטית אין ערובה כלל; אקראית — הצלחה בהסתברות , עם הסף . הסף נותן וזה אופטימלי.
- Freivalds: ; אם מקבל בהסתברות ; אם מקבל בהסתברות . טעות חד-צדדית.
- הגברה: הרצות בלתי תלויות שגיאה בזמן . שגיאה .
המלכודות הסטנדרטיות.
- מלכודת מרחב המדגם. לזהות את עם קבוצת הפלטים במקום עם תוצאות הניסוי. בבעיית המזכיר , לא .
- מלכודת "הסתברות שהאלגוריתם צודק". אסור לכתוב ביטוי כזה בלי לפצל קודם לפי סוג הקלט; הפיצול הוא מחוץ להסתברות, כי הקלט אינו אקראי.
- מלכודת "לכל היותר אחד". בספירה של משפט 3, לכל קביעת יש לכל היותר ערך אחד תקין ל- — ולא בהכרח בדיוק אחד, כי הערך המבוקש עלול כלל לא להיות ב-. כתיבת "בדיוק אחד" היא טעות (אם כי במקרה הזה היא לא מקלקלת את החסם, כי אנחנו חוסמים מלמעלה).
- מלכודת ה-WLOG. מותר לקבוע ש- בתוך חישוב הסתברות רק משום ש- קבועה ואינה תלויה ב-. אילו הייתה אקראית, "ללא הגבלת הכלליות" היה טיעון פסול.
- מלכודת ההגברה. הכלל "קבל רק אם כל ההרצות קיבלו" נכון רק כשהטעות חד-צדדית מסוג false positive. עם טעות דו-צדדית הוא הורס את צד ה-yes-instance, וצריך הצבעת רוב.
- מלכודת מאורע לא אקראי. לא לדבר על הסתברות של מאורע שאינו פונקציה של האקראיות.
צ'ק-ליסט: אחרי השיעור צריך לדעת
- לנסח מהו אלגוריתם אקראי ולציין במדויק, לגבי כל טענה, על מה נלקחת ההסתברות ולאילו קלטים היא תקפה.
- לזהות את מרחב המדגם של אלגוריתם אקראי נתון ולחשב בו הסתברות בספירה קומבינטורית.
- לבנות טיעון אויב שמראה שאלגוריתם דטרמיניסטי נכשל, ולהסביר מדוע האקראיות שוברת אותו.
- לכתוב את אלגוריתם Freivalds, לנמק את זמן הריצה דרך האסוציאטיביות, ולשחזר את שרשרת החסמים על כל צעדיה.
- לחשב את הסתברות הטעות אחרי חזרות בלתי תלויות, ולבחור שמשיג יעד שגיאה נתון (למשל או ).
- להסביר מה טעות חד-צדדית, למה היא הופכת את ההגברה לטריוויאלית, ומה משתנה בלעדיה.